Статистика
Статистика (Statistics) — отрасль знаний, в которой излагаются общие вопросы сбора, измерения и анализа массовых статистических (количественных или качественных) данных; изучение количественной стороны массовых общественных явлений в числовой форме.
Статистическую работу с данными обычно делят на три перекрывающиеся фазы: сбор данных (включая планирование эксперимента), их описание и анализ, цель которого — сделать обоснованные выводы о мире по наблюдениям1. Описанием занимается описательная статистика, выводами — статистический вывод; математическим фундаментом обеих служит теория вероятностей. В инженерной практике статистика применяется для разведочного анализа данных, характеристики измерительных и производственных процессов, моделирования процессов, их улучшения, мониторинга и управления, сравнения изделий и процессов, оценки надежности2.
Основные понятия
Заголовок раздела «Основные понятия»- Генеральная совокупность и выборка. Выводы делаются о совокупности (или о случайном процессе, порождающем данные), а наблюдается конечная выборка из нее. Поэтому статистические выводы всегда формулируются в вероятностных терминах1.
- Статистика (statistic) в узком смысле — любая величина, которую можно вычислить по собранным данным: среднее, число определенных исходов, сумма квадратов и т. п. Вероятность события или параметр распределения статистикой не являются — это свойства изучаемого процесса, которые статистика позволяет оценить1.
- Статистическая модель — предположение о вероятностном механизме, порождающем данные, например «ошибки измерения распределены нормально». Данные используются, чтобы оценить параметры модели или проверить гипотезы о них1.
Описательная статистика
Заголовок раздела «Описательная статистика»Описательная статистика сводит массив данных к немногим сводным показателям и наглядным графикам. Это помогает и сообщать результаты, и исследовать структуру данных — например, понять, какому распределению они могут следовать1. Основные графические средства — гистограмма, которая показывает центр, разброс, асимметрию, выбросы и многомодальность распределения3, и диаграмма рассеяния для пары переменных.
Числовые показатели делятся на три группы по тому, какую сторону распределения они описывают.
Меры положения
Заголовок раздела «Меры положения»Меры положения (центральной тенденции) показывают типичное значение признака в совокупности4:
- Среднее арифметическое — сумма значений, деленная на их число.
- Медиана — значение, которое делит упорядоченную выборку пополам. Она опирается на ранги, поэтому крайние значения ее не искажают, тогда как среднее к ним чувствительно.
- Мода — наиболее часто встречающееся значение; обычно ее оценивают по гистограмме.
- Усеченное среднее и другие компромиссные оценки — среднее, вычисленное после отбрасывания заданной доли крайних значений с каждого конца.
Медиана — частный случай квантиля: значения, ниже которого лежит заданная доля данных (медиана — 50 %, квартили — 25 % и 75 %). Вспомогательные показатели выборки — ее объем, минимум и максимум.
Меры рассеяния
Заголовок раздела «Меры рассеяния»Меры рассеяния (разброса, масштаба) показывают, насколько сильно значения отклоняются друг от друга и от центра5:
- Дисперсия — средний квадрат отклонения от среднего (для выборки сумма квадратов делится на N − 1). Из-за возведения в квадрат сильно реагирует на «хвосты» распределения.
- Стандартное (среднеквадратическое) отклонение — квадратный корень из дисперсии, выражается в тех же единицах, что и данные.
- Размах — разность максимума и минимума; зависит только от двух крайних точек.
- Межквартильный размах — разность 75-го и 25-го процентилей, разброс средней половины данных.
- Среднее абсолютное отклонение — среднее модулей отклонений от среднего; крайние значения влияют на него слабее, чем на дисперсию.
- Медианное абсолютное отклонение — медиана модулей отклонений от медианы; наименее чувствительна к хвостам из перечисленных мер.
Меры формы распределения
Заголовок раздела «Меры формы распределения»- Асимметрия (skewness) — мера несимметричности распределения относительно центра. Отрицательное значение указывает на длинный левый хвост, положительное — на длинный правый; у нормального распределения асимметрия равна нулю6.
- Эксцесс (kurtosis) — мера того, насколько «тяжелы» хвосты распределения по сравнению с нормальным, т. е. насколько данные склонны к выбросам. В исходном определении у нормального распределения эксцесс равен 3; часто из него вычитают 3, и тогда нормальному распределению соответствует ноль. Поэтому при сравнении значений нужно знать, какое определение использует программа6.
Стандартная ошибка среднего и доверительный интервал, которые нередко выводятся вместе с описательными показателями, относятся уже к статистическому выводу: они характеризуют не сами данные, а точность оценки параметра совокупности (см. ниже).
Теория вероятностей
Заголовок раздела «Теория вероятностей»Теория вероятностей дает язык, на котором формулируются статистические модели и выводы.
-
Случайное событие — подмножество множества всех возможных исходов (пространства элементарных исходов) повторяемого эксперимента с четко определенными исходами7. При многократном повторении эксперимента частота наступления события служит оценкой его вероятности.
-
Вероятность — количественная мера возможности наступления события.
-
Условная вероятность P(A|B) — вероятность события A при условии, что событие B произошло. Она равна доле вероятности B, приходящейся на совместное наступление A и B: P(A|B) = P(A ∩ B) / P(B) при P(B) ≠ 08.
-
Математическое ожидание — теоретическое среднее случайной величины, характеристика распределения, а не выборки; выборочное среднее служит его оценкой.
-
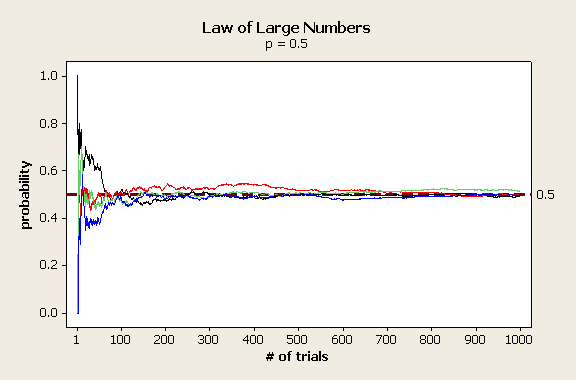
Закон больших чисел: среднее большого числа независимых наблюдений из одного распределения с вероятностью, близкой к единице, близко к математическому ожиданию этого распределения, причем вероятность отклонения больше любой заданной величины стремится к нулю с ростом числа наблюдений9. Различают слабый закон больших чисел (сходимость по вероятности) и усиленный (сходимость почти наверное). Закон касается только случайной ошибки: если прибор неисправен или плохо откалиброван, среднее многих измерений будет точной оценкой неверной величины9.
-
Центральная предельная теорема: сумма или среднее большого числа независимых одинаково распределенных случайных величин распределены приближенно нормально; для среднего — с математическим ожиданием μ и дисперсией σ²/n9. Более общие формулировки допускают слабо зависимые слагаемые с сопоставимыми масштабами, ни одно из которых не вносит определяющего вклада.
Математическая статистика
Заголовок раздела «Математическая статистика»- Параметрическая модель — семейство распределений, каждое из которых задается значением параметра (например, нормальное N(μ, σ²) задается двумя параметрами)10.
- Функция правдоподобия — вероятность (или плотность вероятности) наблюденных данных при данном значении параметра, P(данные | θ), рассматриваемая как функция параметра θ. Ее не следует путать с вероятностью параметра при данных, P(θ | данные)10.
- Оценка максимального правдоподобия — значение параметра, при котором наблюденные данные наиболее вероятны, т. е. которое максимизирует функцию правдоподобия. Это точечная оценка10.
- Экспоненциальное семейство распределений — класс распределений, плотность которых имеет вид h(x) · exp(ηᵀT(x) − A(η)), где T(x) — достаточная статистика. В него входят нормальное, биномиальное, мультиномиальное, пуассоновское, гамма- и бета-распределения и многие другие; общий вид позволяет получать результаты сразу для всего класса11.
Статистический вывод
Заголовок раздела «Статистический вывод»Статистический вывод — получение заключений о совокупности или о модели по выборке. Основные формы:
- Точечная оценка параметра, например оценка максимального правдоподобия.
- Интервальная оценка. Так, доверительные границы для среднего строятся как выборочное среднее плюс-минус квантиль t-распределения, умноженный на s/√N, где s — выборочное стандартное отклонение, N — объем выборки12. Величина s/√N — стандартная ошибка среднего.
- Проверка гипотез. Пример — однофакторный дисперсионный анализ (ANOVA), который проверяет, одинаковы ли средние в нескольких группах, например результаты измерений на пяти разных приборах13.
Статистические методы
Заголовок раздела «Статистические методы»- Регрессионный анализ (Regression analysis) — построение модели, которая разлагает изменчивость отклика на детерминированную часть (функцию объясняющих переменных) и случайную ошибку, подчиняющуюся вероятностному распределению14.
- Дисперсионный анализ (Analysis of variance, ANOVA) — разложение изменчивости отклика на эффекты факторов и ошибку для сравнения средних по группам13.
- Оценка плотности (Density estimation) — восстановление плотности распределения по выборке. Простейшая оценка — гистограмма; ядерная оценка плотности (kernel density estimation) уточняет ее: вместо столбцов строится гладкая кривая как сумма «ядер», центрированных в точках данных, а ширина окна задает степень сглаживания15.
- Анализ временных рядов (Time series analysis) — методы для данных, собранных во времени, которые учитывают их внутреннюю структуру: автокорреляцию, тренд, сезонность. Сюда входят скользящие средние, экспоненциальное сглаживание, модели Бокса — Дженкинса и многомерные модели временных рядов16.
- Многомерный анализ (Multivariate analysis):
- Метод главных компонент (Principal component analysis, PCA) — способ уменьшить размерность данных: большой набор коррелированных переменных заменяется меньшим набором некоррелированных линейных комбинаций, сохраняющим бо́льшую часть информации; каждая компонента строится так, чтобы ее дисперсия была максимальной17.
- Факторный анализ (Factor analysis) — многомерный метод, применяемый для изучения взаимосвязей между значениями переменных. Предполагается, что известные переменные зависят от меньшего количества неизвестных переменных и случайной ошибки.
- Кластерный анализ (Cluster analysis) — многомерная статистическая процедура, которая упорядочивает объекты выборки в сравнительно однородные группы.
- Робастные методы (Robust statistics) — оценки, устойчивые к выбросам и отклонениям распределения от предполагаемого (например, от нормального). Примеры — медиана и усеченное среднее вместо среднего, межквартильный размах и медианное абсолютное отклонение вместо стандартного отклонения45.
Литература
Заголовок раздела «Литература»- Jordan M. I. The exponential family: Basics. Глава 8 материалов курса Stat 260, University of California, Berkeley.
- Orloff J., Bloom J. Introduction to Probability and Statistics: Readings. Курс 18.05, MIT OpenCourseWare, весна 2022.
- NIST/SEMATECH e-Handbook of Statistical Methods — справочник по инженерной статистике Национального института стандартов и технологий США (DOI 10.18434/M32189)
- Kernel Density Plot — описание ядерной оценки плотности в справочнике программы Dataplot, NIST
- Seeing Theory — наглядное введение в теорию вероятностей и статистику, Брауновский университет
См. также
Заголовок раздела «См. также»- Наука о данных
- Машинное обучение
- Байесовский анализ
- Моделирование методом Монте-Карло
- Теория массового обслуживания
Примечания
Заголовок раздела «Примечания»-
Orloff J., Bloom J. Introduction to Statistics. Reading 10a. MIT OpenCourseWare, 18.05, Spring 2022. ↩ ↩2 ↩3 ↩4 ↩5
-
NIST/SEMATECH e-Handbook of Statistical Methods, структура глав справочника. ↩
-
1.3.3.14. Histogram. NIST/SEMATECH e-Handbook of Statistical Methods. ↩
-
1.3.5.1. Measures of Location. NIST/SEMATECH e-Handbook of Statistical Methods. ↩ ↩2
-
1.3.5.6. Measures of Scale. NIST/SEMATECH e-Handbook of Statistical Methods. ↩ ↩2
-
1.3.5.11. Measures of Skewness and Kurtosis. NIST/SEMATECH e-Handbook of Statistical Methods. ↩ ↩2
-
Orloff J., Bloom J. Probability: Terminology and Examples. Reading 2. MIT OpenCourseWare, 18.05, Spring 2022. ↩
-
Orloff J., Bloom J. Conditional Probability, Independence and Bayes’ Theorem. Reading 3. MIT OpenCourseWare, 18.05, Spring 2022. ↩
-
Orloff J., Bloom J. Central Limit Theorem and the Law of Large Numbers. Reading 6b. MIT OpenCourseWare, 18.05, Spring 2022. ↩ ↩2 ↩3
-
Orloff J., Bloom J. Maximum Likelihood Estimates. Reading 10b. MIT OpenCourseWare, 18.05, Spring 2022. ↩ ↩2 ↩3
-
Jordan M. I. The exponential family: Basics, раздел 8.1. ↩
-
1.3.5.2. Confidence Limits for the Mean. NIST/SEMATECH e-Handbook of Statistical Methods. ↩
-
1.3.5.4. One-Factor ANOVA. NIST/SEMATECH e-Handbook of Statistical Methods. ↩ ↩2
-
4.1.1. What is process modeling? NIST/SEMATECH e-Handbook of Statistical Methods. ↩
-
Kernel Density Plot. Dataplot Reference Manual, NIST. ↩
-
6.4. Introduction to Time Series Analysis. NIST/SEMATECH e-Handbook of Statistical Methods. ↩
-
6.5.5. Principal Components. NIST/SEMATECH e-Handbook of Statistical Methods. ↩